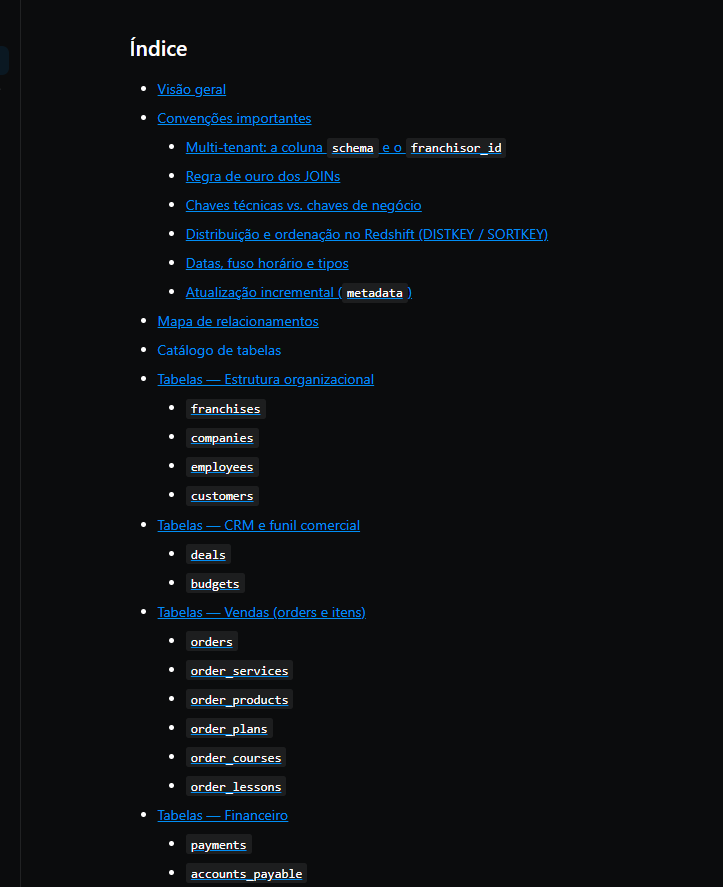
O UNO DataLake centraliza os dados operacionais das franqueadoras em um ambiente analítico, permitindo a criação de dashboards, relatórios e integrações com ferramentas de Business Intelligence (BI).
A documentação técnica apresenta a estrutura das tabelas disponíveis, seus campos, relacionamentos, exemplos de consultas SQL e boas práticas para utilização do ambiente.
⚠ Importante: O UNO DataLake é um recurso destinado exclusivamente às franqueadoras.
Antes de começar a utilizar o UNO DataLake, recomendamos seguir esta sequência:
Acesse a documentação oficial.
Consulte as convenções gerais do DataLake.
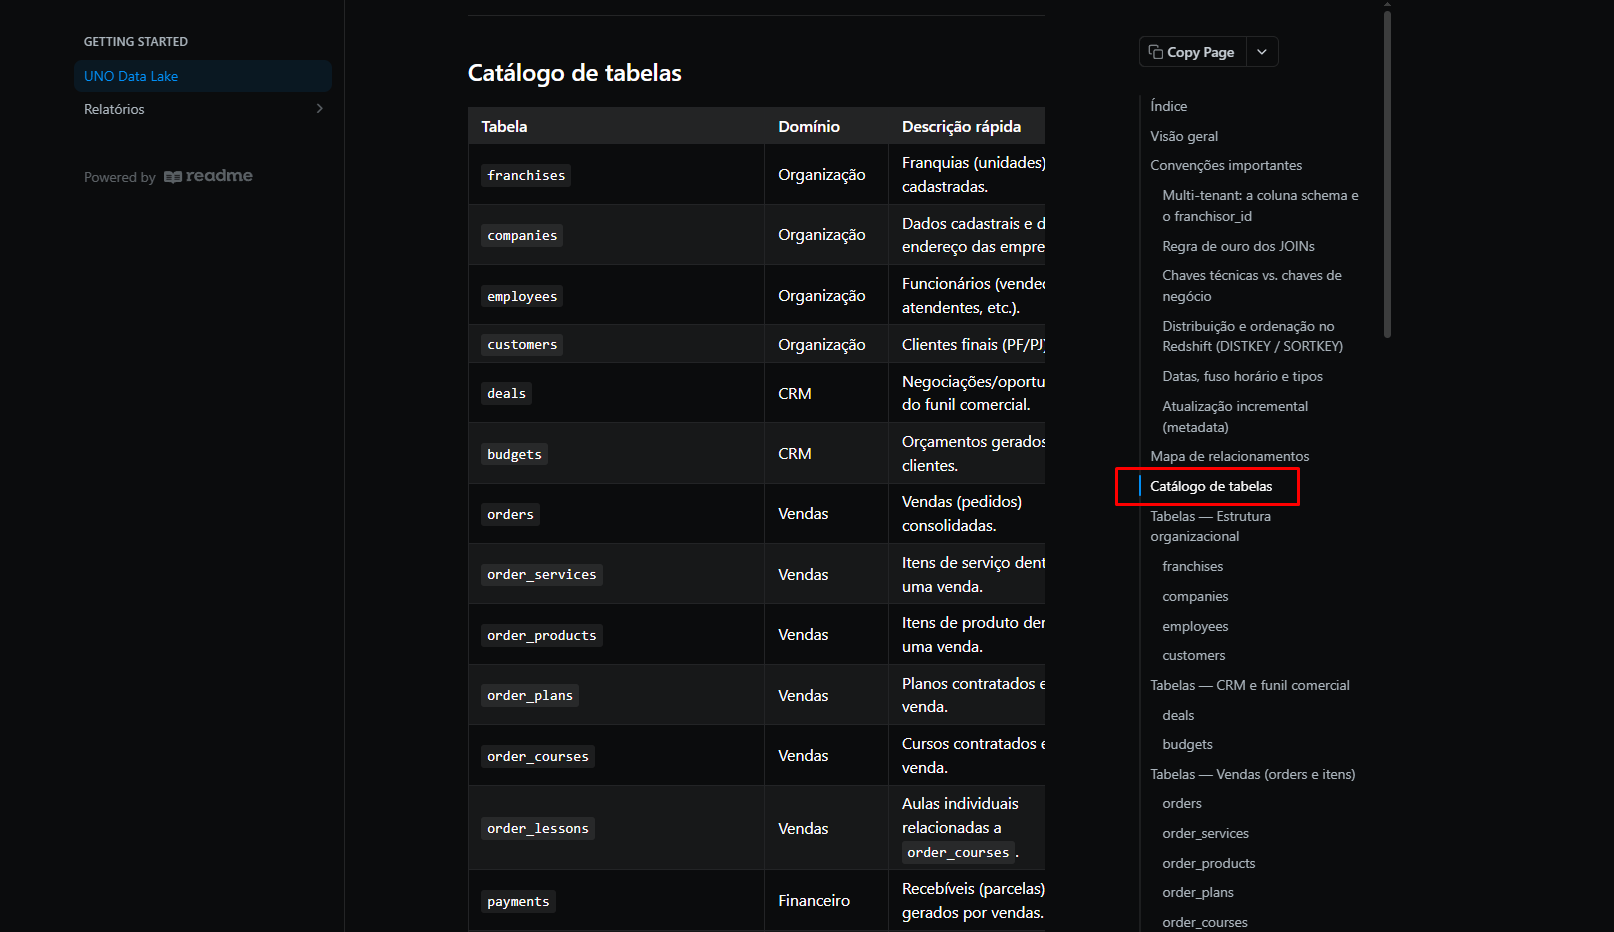
Localize a tabela desejada no catálogo.
Analise os campos disponíveis.
Consulte os exemplos de consultas SQL.
Utilize as boas práticas antes de construir seus relatórios.
A documentação está organizada em seções para facilitar a localização das informações.
Entre os principais conteúdos estão:
Visão geral do DataLake;
Convenções e regras de utilização;
Catálogo completo das tabelas;
Estrutura e descrição dos campos;
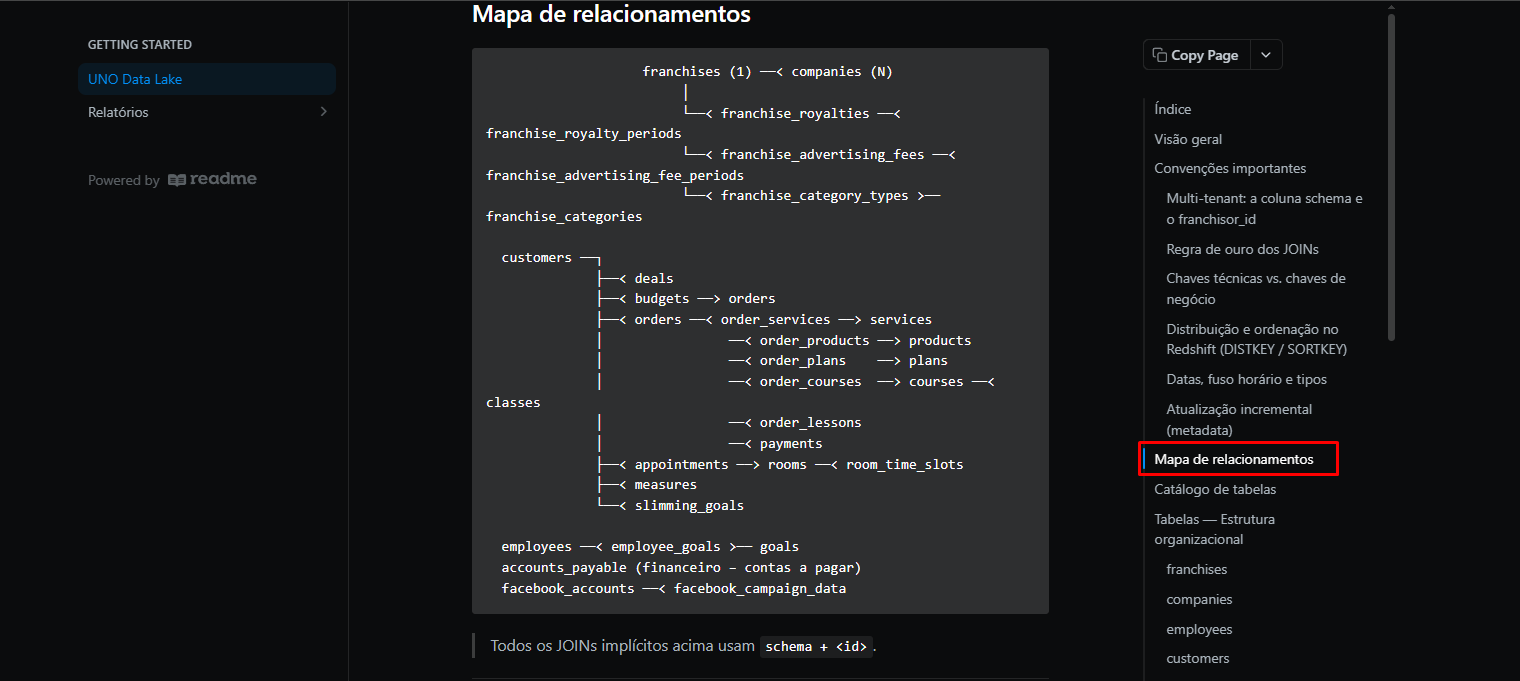
Relacionamentos entre tabelas;
Exemplos de consultas SQL;
Boas práticas para consultas no Amazon Redshift.
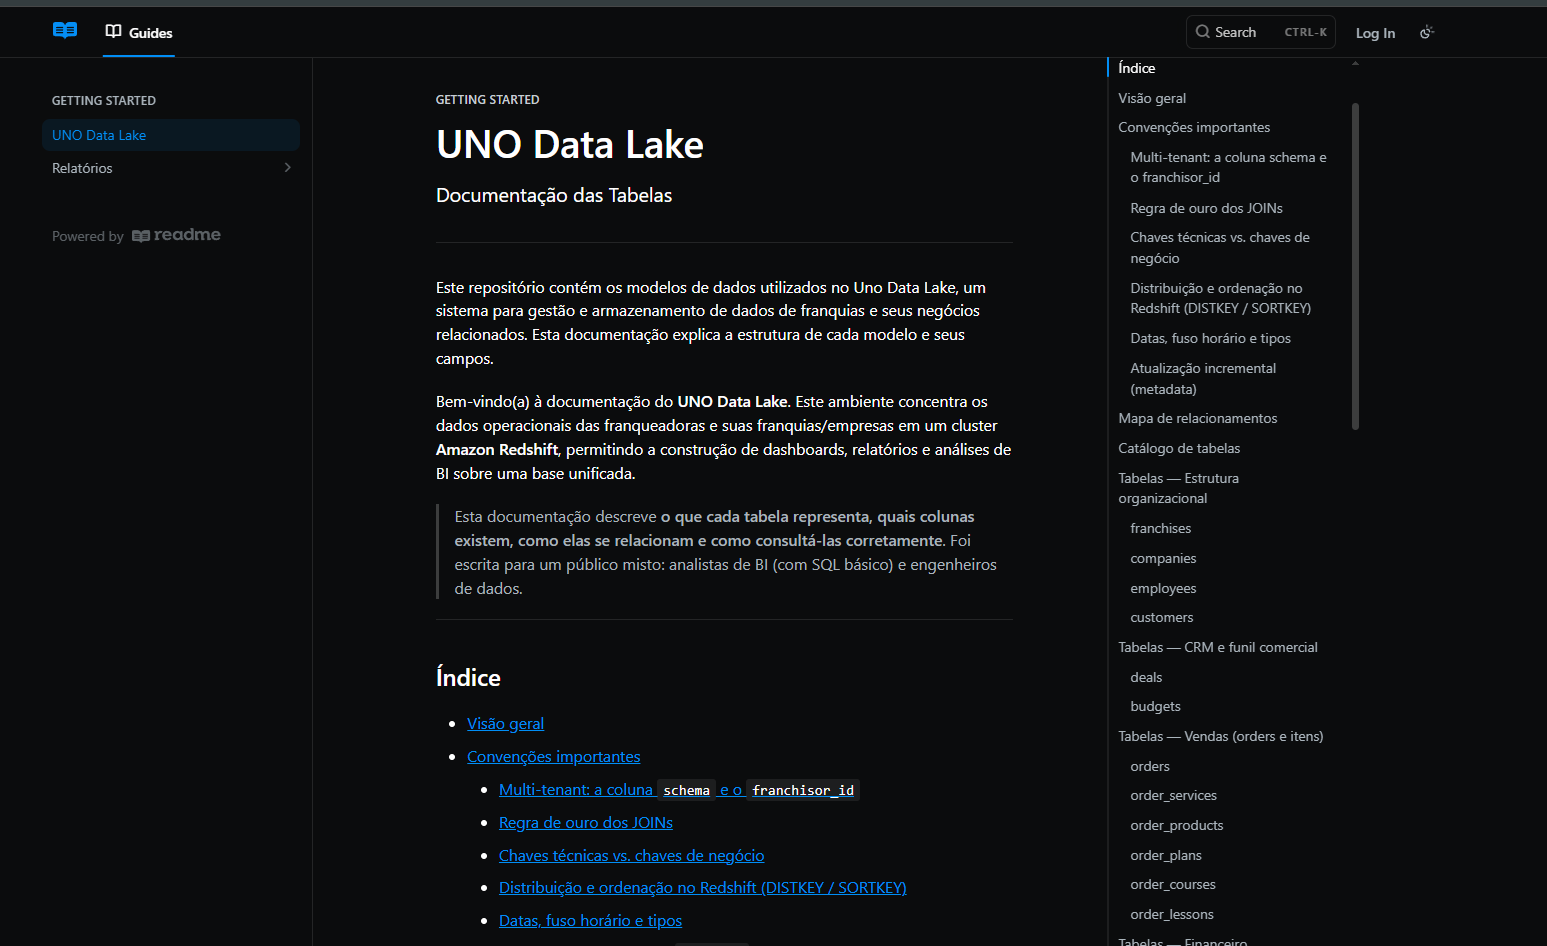
As tabelas estão agrupadas por domínio de negócio, facilitando sua localização.
Entre os grupos disponíveis estão:
Estrutura Organizacional;
CRM;
Vendas;
Financeiro;
Catálogo;
Atendimento;
Metas;
Marketing;
Sistema.
💡 Dica: Utilize o campo Search da documentação para localizar rapidamente uma tabela ou termo específico.
Cada tabela da documentação apresenta informações importantes para auxiliar na construção das consultas.
Você encontrará:
Descrição da tabela;
Finalidade dos dados;
Nome das colunas;
Tipo de dado;
Permissão para valores nulos;
Descrição de cada campo.
A documentação também apresenta um mapa de relacionamento entre as principais tabelas do DataLake, facilitando a compreensão de como os dados estão organizados.
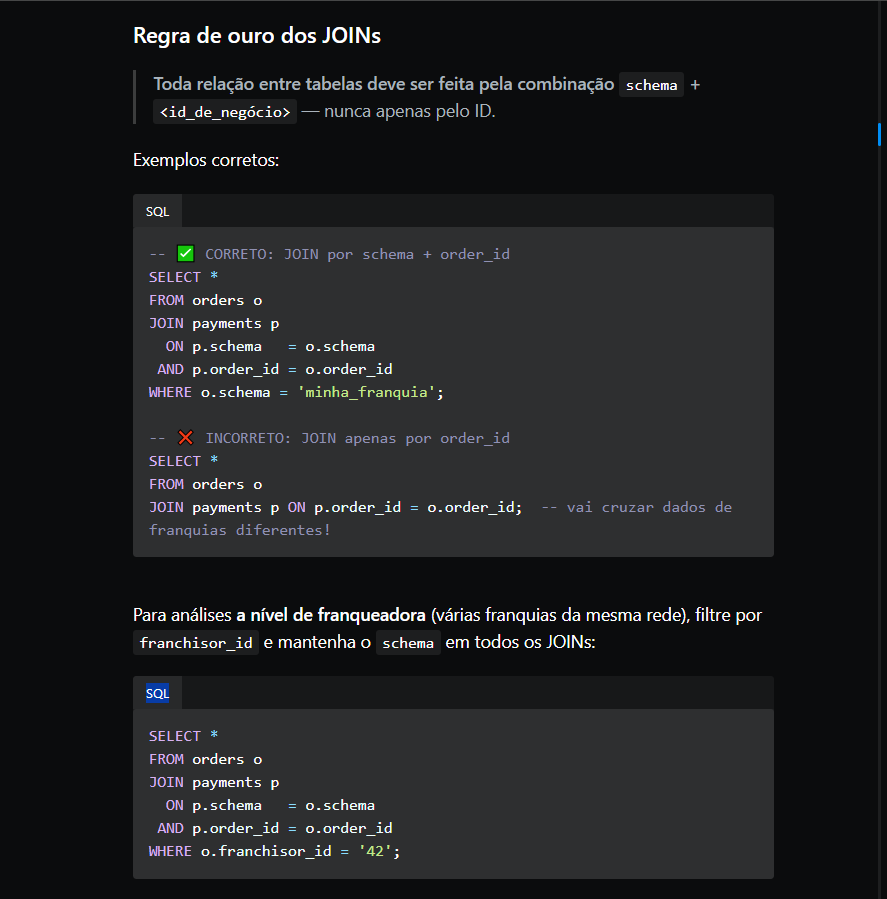
Além disso, todas as relações devem ser realizadas utilizando a combinação:
schema
ID da entidade
Essa prática garante consultas corretas e evita o cruzamento de informações entre franquias diferentes.
Para facilitar o desenvolvimento de dashboards e relatórios, a documentação disponibiliza exemplos prontos de consultas SQL para cenários comuns, como:
Faturamento mensal;
Recebíveis pendentes;
Ranking de vendedores;
Conversão do funil comercial;
Ocupação da agenda;
Custo por lead;
Consolidação de dados por franqueadora.
schemaO campo schema identifica a franquia proprietária dos dados e deve ser utilizado em todas as consultas realizadas no UNO DataLake.
Além de garantir que apenas os dados da franquia desejada sejam consultados, seu uso contribui para um melhor desempenho das consultas.
Ao relacionar tabelas, utilize sempre a combinação:
schema
ID da entidade (por exemplo: order_id, customer_id ou appointment_id).
Evite realizar JOINs utilizando apenas o ID da entidade, pois diferentes franquias podem possuir registros com o mesmo identificador, resultando em dados incorretos.
Diversas tabelas já possuem informações desnormalizadas, como os campos terminados em _name, permitindo consultar nomes de clientes, produtos, serviços e outras entidades sem a necessidade de realizar JOINs adicionais.
A documentação disponibiliza exemplos de consultas SQL para diferentes cenários de análise.
Sempre que possível, utilize esses exemplos como base para desenvolver suas próprias consultas, adaptando-os conforme a necessidade do seu projeto.
Como a documentação original dá bastante ênfase à performance no Amazon Redshift, eu incluiria uma última dica:
Evite consultar colunas desnecessárias ou grandes volumes de dados quando não forem necessários.
Consultas mais específicas tendem a apresentar melhor desempenho e facilitam a construção de relatórios e dashboards.
Caso encontre dúvidas durante a utilização do UNO DataLake, recomendamos informar ao suporte:
A tabela consultada;
A consulta SQL utilizada (quando aplicável);
A mensagem de erro apresentada;
Prints da tela ou evidências do problema.
Essas informações facilitam a análise e agilizam o atendimento.